Как читать статистику: расчёт выборки
Размер выборки: сколько нужно наблюдений
Чтобы найти разницу, нужно достаточное число наблюдений. Если их мало, разницу можно не увидеть. Если слишком много, мы зря потратим время и силы. Ниже простыми словами: какие величины нужны, как считается размер и где обычно ошибаются.
Калькулятор размера выборки
Считает число наблюдений для четырёх типовых задач. Значения по умолчанию можно изменить.
Выберите задачу, заполните поля и нажмите «Рассчитать».
Где считать на практике
Для подготовки данных и расчётов в проектах используется АвИ Орбита: среда для работы с таблицами, проверки качества данных и построения моделей.
Результат
Значение выводится по нажатию кнопки.
Зачем считать заранее
Размер выборки считают до начала сбора данных. Он показывает, сколько наблюдений нужно, чтобы заметить разницу заданной величины.
Есть три величины, которые связаны между собой: ожидаемая разница, допустимая доля случайных результатов и число наблюдений. При изменении одной величины меняются остальные.
Если посчитать после сбора данных, получится подгонка под уже известный ответ. Так делать нельзя.
Что нужно знать перед расчётом
| Величина | Простыми словами | Обычное значение |
|---|---|---|
| Уровень значимости, α | Какую долю ложных результатов мы готовы допустить | 0,05, то есть 5 из 100 |
| Мощность | Как часто мы найдём разницу, если она есть на самом деле | 0,80 или 0,90 |
| Минимальная разница | Наименьшая разница, которую важно не пропустить | задаёт исследователь |
| Разброс | Насколько сильно значения отличаются друг от друга | из пилота или прошлых работ |
| Доля | Как часто событие встречается в группе | из литературы |
| Выбывание | Какая часть участников не дойдёт до анализа | от 10 до 30 процентов |
Уровень значимости и мощность выбирают до расчёта. Если поднять мощность с 0,80 до 0,90, наблюдений понадобится примерно на четверть больше.
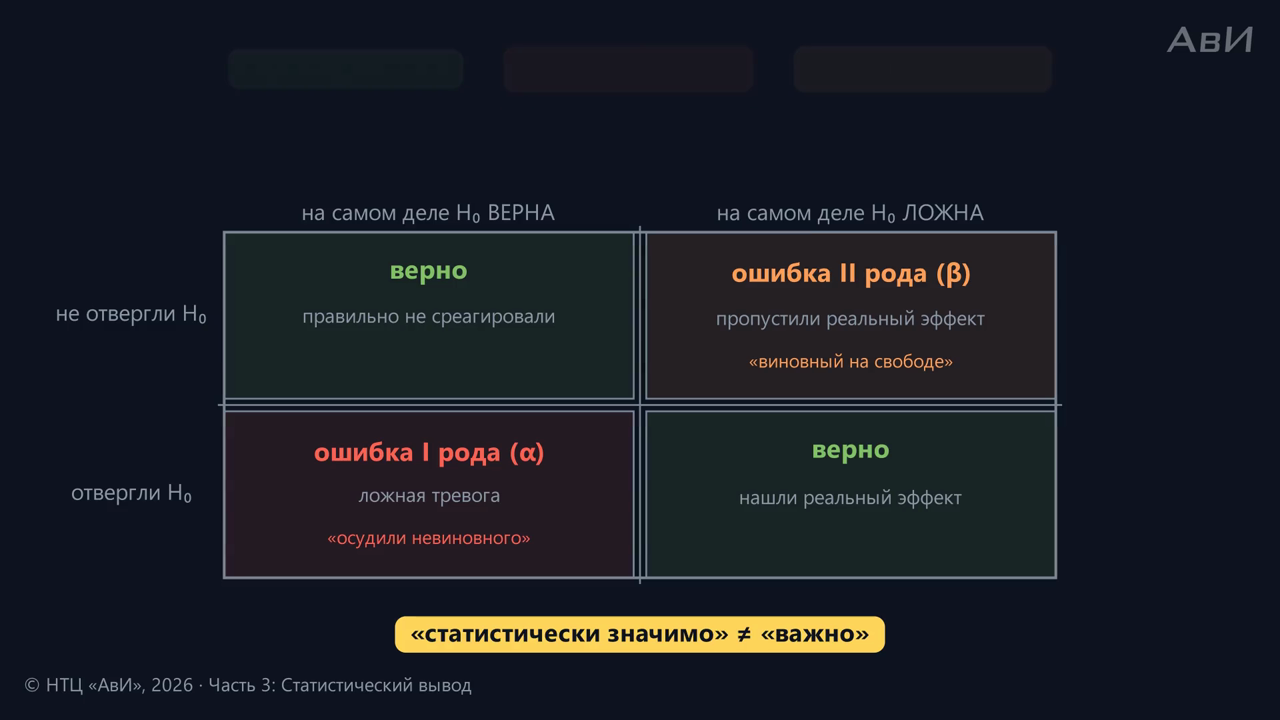
Как считается
Формул несколько, выбор зависит от того, что сравнивают: средние значения, доли или связь между признаками.
Две группы, сравниваем средние
n = 2 · (1,96 + 0,84)² · σ² / Δ²
n это число наблюдений в каждой группе. Числа 1,96 и 0,84 взяты из таблицы нормального распределения: первое для уровня значимости 0,05, второе для мощности 0,80. σ это разброс, Δ это минимальная разница, которую хотим заметить.
Одна группа, оцениваем среднее
n = (1,96 + 0,84)² · σ² / Δ²
Две группы, сравниваем доли
n = (1,96 · √(2p̄(1-p̄)) + 0,84 · √(p₁(1-p₁) + p₂(1-p₂)))² / (p₁-p₂)²
p₁ и p₂ это ожидаемые доли в группах, p̄ это средняя доля по двум группам.
Оценка связи двух признаков
n = ((1,96 + 0,84) / (0,5 · ln((1+r)/(1-r))))² + 3
r это ожидаемый коэффициент корреляции. Логарифм здесь нужен, чтобы привести коэффициент к удобной шкале.
Поправка на выбывание
N = n / (1 - d)
N это сколько человек нужно включить. n это сколько нужно до анализа. d это доля выбывших, например 0,15.
Вы можете проводить расчёты без сложных формул в АвИ Орбита.
Пример
Сравниваем две группы по числовому признаку. Разброс σ равен 10. Разницу меньше 5 единиц замечать не собираемся. Уровень значимости 0,05, мощность 0,80.
- Складываем 1,96 и 0,84, получаем 2,80.
- Возводим в квадрат, получаем 7,84.
- Умножаем на 2 и на 100, получаем 1568.
- Делим на 25, получаем 62,7.
- Округляем вверх: по 63 наблюдения в каждой группе.
- Если 15 процентов участников выбудут, делим 63 на 0,85 и получаем 74. Округляем: по 75 человек в группе.
Проверка: при 63 наблюдениях в группе и разбросе 10 мы заметим разницу около 5 единиц с вероятностью 0,80. Это то, что и планировали.
Что меняет результат
| Изменение условия | Число наблюдений |
|---|---|
| Уменьшение минимальной разницы вдвое | Растёт вчетверо |
| Увеличение разброса вдвое | Растёт вчетверо |
| Повышение мощности с 0,80 до 0,90 | Растёт примерно на четверть |
| Снижение уровня значимости с 0,05 до 0,01 | Растёт примерно на треть |
| Неравные группы, один к двум | Растёт примерно на 12 процентов |
| Парные измерения, до и после | Снижается, если пары похожи между собой |
Если сравнений несколько
Когда проверяют сразу несколько гипотез, шанс получить хотя бы один ложный результат растёт. При пяти независимых сравнениях и уровне 0,05 он доходит примерно до 0,23.
Поэтому либо ужесточают уровень значимости для каждого сравнения, либо считают размер под главную гипотезу, а остальные называют второстепенными и описывают без проверки.
Частые ошибки
- Расчёт под уже полученную разницу
- Берут разницу из своих данных и по ней обосновывают размер. Для расчёта нужна наименьшая важная разница, а не та, что получилась.
- Не учитывают выбывание
- Включают ровно столько человек, сколько нужно до анализа. Часть выбудет, и мощность упадёт.
- Разброс оценён приблизительно
- Разброс входит в формулу в квадрате. Ошибка вдвое меняет результат в четыре раза.
- Смешение статистической значимости и практической важности
- На большой выборке значимой станет и ничтожная разница. Наименьшую важную разницу задают до расчёта, по смыслу.
- Не учитывают повторные измерения и кластеризацию
- Если один человек измерен несколько раз или участники собраны по центрам, обычные формулы занижают нужное число наблюдений.
Источники
- Cohen J. Statistical Power Analysis for the Behavioral Sciences. 2-е изд. Lawrence Erlbaum, 1988.
- Chow S.-C., Shao J., Wang H. Sample Size Calculations in Clinical Research. 2-е изд. Chapman & Hall/CRC, 2008.
- Machin D., Campbell M. J., Tan S. B., Tan S. H. Sample Size Tables for Clinical Studies. 3-е изд. Wiley-Blackwell, 2009.
- Schulz K. F., Grimes D. A. Sample size calculations in randomised trials: mandatory and mystical. The Lancet, 2005, том 365, с. 1348-1353.
- Button K. S. и соавт. Power failure: why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 2013, том 14, с. 365-376.